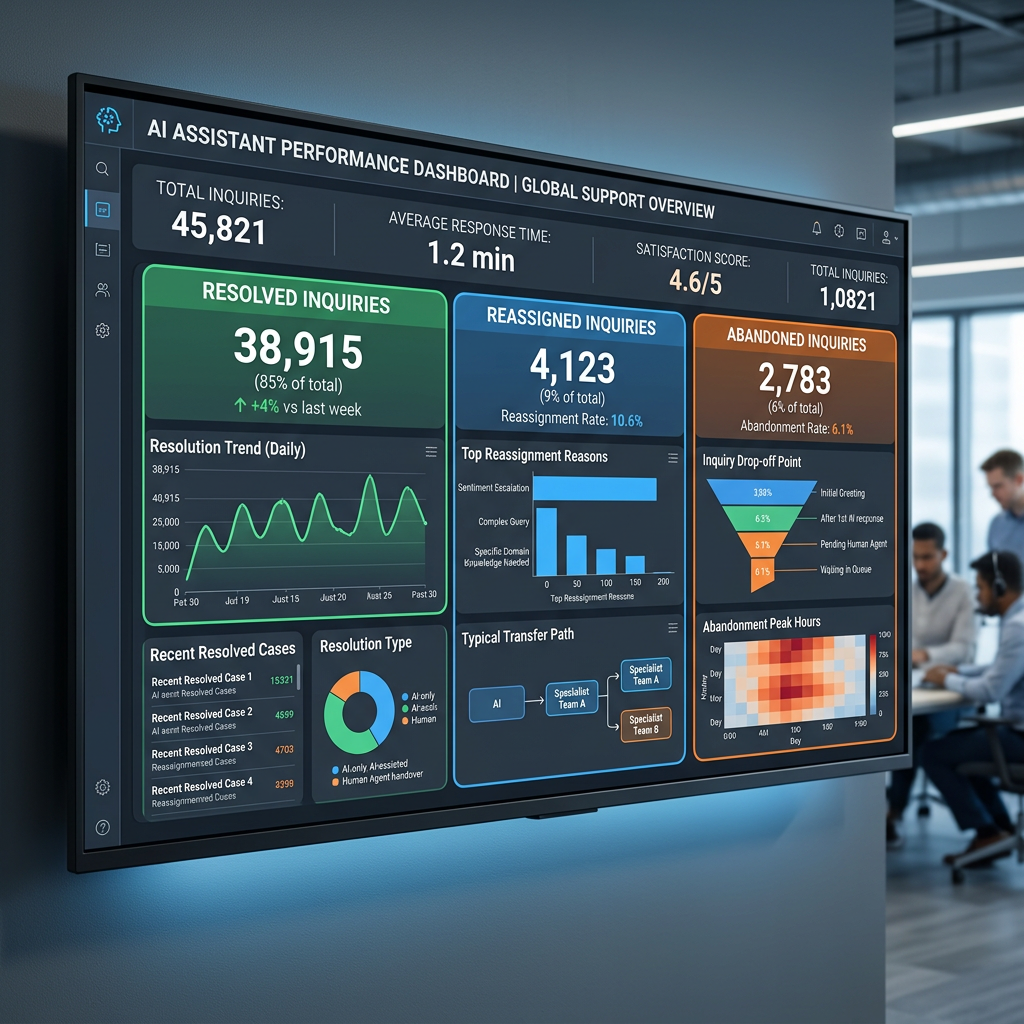
TL;DR — Un mese dopo aver lanciato Bussola, il mio agente Copilot Studio per la ricerca lavoro, il bilancio è misto: buon tasso di risoluzione sulle domande semplici, ma escalation frequenti sui casi ambigui e una base di conoscenza da correggere due volte. La lezione più grande: senza metriche vere (non vanity), non sai se il tuo agente funziona o sembra solo funzionare.
Un mese dopo, senza birre ma con più dati
Il 15 luglio ho raccontato come ho costruito Bussola in una notte, tra birre e un’amicizia. Da allora sono passate quattro settimane, qualche decina di conversazioni reali e due revisioni della fonte di conoscenza che avevo scritto convinto fosse già solida. Non lo era.
Quello che segue non è un post di vittoria. È una retrospettiva onesta, con i numeri che ho potuto guardare davvero (analytics di Copilot Studio) e le correzioni che ho dovuto fare. Se stai per lanciare un agente in PMI, questo articolo ti risparmia almeno un paio di errori che ho fatto io.
Perché la maggior parte degli agenti muore in silenzio dopo il lancio
Un agente AI non fallisce quasi mai nel giorno del lancio: fallisce nelle settimane successive, quando nessuno guarda più i numeri giusti. Secondo l’analisi di RAND Corporation su oltre 2.400 iniziative aziendali di AI, l’80% dei progetti non riesce a produrre valore di business misurabile, il doppio del tasso di fallimento dei progetti IT tradizionali (Folio3 AI, 2026).
Il dato più duro arriva da MIT Project NANDA: il 95% dei pilot di AI generativa produce un impatto zero sul conto economico (P&L). Non basso: zero. Un report DigitalOcean di marzo 2026 aggiunge una sfumatura utile: il 67% delle organizzazioni registra benefici misurabili dai pilot di agenti AI, ma solo il 10% riesce a farli scalare in produzione stabile (via Bonjoy, 2025). Il problema, quindi, non è quasi mai “l’agente non funziona”: è che nessuno ha definito cosa significhi “funzionare”.
Quali metriche guardare davvero per valutare un agente dopo il lancio?
Le metriche che contano davvero sono quelle legate a un risultato di business definito prima del lancio, non ai conteggi di sessioni o utenti attivi. Microsoft Learn distingue quattro driver di valore (efficienza, esperienza, crescita, rischio) e ricorda che “quando il tuo agente entra in produzione, sposta la tua attenzione dall’intenzione alle evidenze”.
Per Bussola ho tenuto d’occhio tre cose semplici: tasso di risoluzione, tasso di escalation, tasso di abbandono. Copilot Studio classifica ogni sessione coinvolta in uno di questi tre esiti — Risolto, Riassegnato, Abbandonato — e questa tassonomia da sola mi ha costretto a essere onesto: una conversazione “attiva” non è automaticamente una conversazione riuscita.
| Metrica | Cosa misura | Perché conta |
|---|---|---|
| Tasso di risoluzione | % sessioni chiuse con successo confermato | Distingue l’uso reale dal rumore |
| Tasso di escalation | % sessioni trasferite a un umano/altro canale | Segnala lacune nella base di conoscenza |
| Tasso di abbandono | % sessioni chiuse senza esito | Rivela attrito o domande fuori scope |
| Tasso di deviazione | % conversazioni risolte senza intervento umano | KPI di riferimento suggerito da Microsoft Learn |
Cosa ha funzionato di Bussola nel primo mese?
Ha funzionato bene tutto ciò che avevo previsto esplicitamente in fase di scrittura del manuale: domande dirette su CV, lettere di presentazione e struttura dei colloqui hanno un tasso di risoluzione alto e conversazioni brevi. È la conferma di una regola che avevo già scritto nell’articolo precedente: la qualità della fonte di conoscenza conta più del modello.
Ha funzionato anche l’aneddotica qualitativa: alcune persone che hanno provato Bussola mi hanno scritto di essere tornate a usarlo una seconda volta nella stessa settimana, segnale — per quanto informale — di fiducia ripetuta più che di curiosità isolata.
Cosa non ha funzionato e cosa ho dovuto correggere?
Non ha funzionato la gestione dei casi ambigui: richieste che mescolavano più intenti (es. “aiutami con il CV ma anche a capire se cambiare settore”) generavano escalation o risposte parziali. Ho dovuto riscrivere due sezioni della base di conoscenza e aggiungere esempi di conversazioni miste che prima non avevo previsto.
Il secondo problema è stato di misurazione, non di prodotto: nella prima settimana guardavo solo il numero di sessioni, non gli esiti. È esattamente lo schema che Microsoft Learn descrive come una delle cause per cui “la misurazione si ferma alla fase pilota”: la strumentazione era forte all’inizio e si è affievolita mentre mi concentravo su altro.
Come distinguere un’attività reale da un’illusione di produttività?
Un’attività reale produce un risultato ripetibile collegato a un obiettivo dichiarato in anticipo; un’illusione di produttività produce solo attività — sessioni, click, conversazioni — senza un esito misurabile. Come ricorda Botpress Academy: “Un agente funzionante non è semplicemente quello che è in esecuzione. È quello che genera risultati misurabili e ripetibili in linea con un obiettivo che hai stabilito.”
Per una PMI la domanda pratica è: se spegnessi l’agente oggi, qualcuno se ne accorgerebbe per un motivo di business, o solo perché “prima c’era e ora non c’è”? Se la risposta è la seconda, probabilmente stai misurando vanity metric.
Cosa farei diversamente se ricominciassi oggi?
Definirei i tre esiti (risolto/riassegnato/abbandonato) e la soglia di successo prima di scrivere una singola riga della base di conoscenza, non dopo il lancio. Avrei anche previsto fin da subito i casi “misti” che ho scoperto solo osservando conversazioni reali, invece di aspettare che emergessero come problemi.
Infine, avrei accettato più serenamente che un mese non basta per un giudizio definitivo: è sufficiente per correggere la rotta, non per dichiarare vittoria o sconfitta.
Cosa significa per una PMI italiana che valuta un agente AI
Per una piccola o media impresa italiana, il vero rischio non è costruire un agente che non funziona: è non accorgersene per mesi perché nessuno ha definito in anticipo cosa “funzionare” significhi. I dati su fallimento diffuso dei progetti AI (RAND, MIT NANDA) raccontano aziende grandi con budget importanti; per una PMI l’errore costa meno in valore assoluto, ma pesa di più in proporzione: tempo del titolare, credibilità interna, fiducia dei collaboratori nello strumento.
La buona notizia è che le stesse tre metriche che ho usato per Bussola — risoluzione, escalation, abbandono — si applicano a qualsiasi agente Copilot Studio, anche il più piccolo, e Copilot Studio le fornisce già di default in dashboard. Non serve un data team: serve la disciplina di guardarle ogni settimana, non solo il giorno del lancio.
FAQ
Quanto tempo serve per giudicare se un agente AI funziona?
Un mese è sufficiente per individuare pattern di correzione (base di conoscenza incompleta, casi ambigui, esiti sbilanciati), ma non per un giudizio definitivo su valore di business, che richiede più cicli di misurazione e almeno un trimestre di osservazione continua.
Qual è la metrica più importante per un agente Copilot Studio appena lanciato?
Non ce n’è una sola: la combinazione minima è tasso di risoluzione, tasso di escalation e tasso di abbandono, perché insieme distinguono un uso reale da attività senza esito, secondo la tassonomia di sessione di Copilot Studio.
Perché molti progetti di agenti AI falliscono dopo il pilota?
Perché la misurazione si concentra sull’attività iniziale (sessioni, utenti) invece che sui risultati collegati a un obiettivo di business definito in anticipo, e si affievolisce proprio quando l’agente entra in produzione stabile.
Bussola userà l’intelligenza artificiale per migliorarsi da sola?
No: i miglioramenti descritti in questo articolo (base di conoscenza corretta, casi misti aggiunti) sono stati fatti manualmente da me, osservando le conversazioni reali — non un processo automatico.
Conviene misurare un agente AI anche se è un progetto personale, non aziendale?
Sì: anche un agente personale beneficia di 2-3 metriche minime definite in anticipo, perché senza di esse è impossibile distinguere un miglioramento reale da una percezione soggettiva di “funziona meglio”.
Conclusioni
Un mese dopo Bussola non è né un successo conclamato né un fallimento: è un agente in evoluzione, come qualsiasi sistema che impara dall’uso reale invece che dalla teoria. La lezione che porto avanti nella serie che ho scritto — istruzioni chiare, governance, fonte di conoscenza solida — si chiude qui con l’ingrediente che le tiene insieme: senza metriche vere, tutto il resto rimane un esercizio di fede. Le statistiche di settore (80-95% di progetti AI senza valore misurabile) non sono un allarme lontano: sono il motivo per cui ho passato la seconda settimana a guardare tre numeri invece di ammirare il progetto finito.
Riferimenti
Fonti verificate al 21 luglio 2026.
| Fonte | Autore/Editore | Data | Livello |
|---|---|---|---|
| Misurare l’impatto degli agenti | Microsoft Learn – Copilot Studio Guidance | 2026 | B |
| Misura i risultati degli agenti | Microsoft Learn – Copilot Studio Guidance | 2026 | B |
| Definire gli obiettivi del progetto e i criteri di successo | Microsoft Learn – Copilot Studio Guidance | 2026 | B |
| AI Project Failure Rate in 2026 (cita RAND Corporation, MIT Project NANDA) | Folio3 AI, M. Nasir | 2026 | B |
| Why 88% of AI Agents Fail in Production (cita report DigitalOcean, marzo 2026) | Bonjoy | dic. 2025 | B/C |
| Misurare, monitorare e migliorare un agente AI dopo il lancio | Botpress Academy | 2026 | B |
Link interni
- Microsoft Copilot Studio: come ho costruito “Bussola” in una notte, tra birre e un’amicizia
- Da skill singola ad agente: riusare il know-how in Copilot Studio
- Copilot Studio: la fonte di conoscenza conta più del modello [verificare URL — bozza non ancora pubblicata]
- Copilot Studio: da agente personale ad agente aziendale [verificare URL — bozza non ancora pubblicata]
Lascia un commento